Sora и физика видео: Почему ИИ всё еще путает причину и следствие
Генерация видео с помощью искусственного интеллекта переживает взрывной рост. Модели, такие как Sora от OpenAI, демонстрируют поразительную способность создавать визуально безупречные, кинематографичные сцены на основе текстовых описаний. Однако за фасадом фотореалистичной картинки скрывается фундаментальная проблема: отсутствие понимания базовых законов физики. Генерации часто содержат грубые нарушения причинно-следственных связей, где объекты ведут себя вопреки интуиции и законам Ньютона.
Архитектура диффузии и её ограничения
Sora основана на архитектуре диффузионных трансформеров (DiT). В отличие от GAN, которые часто страдают от нестабильности обучения, диффузионные модели постепенно "очищают" шум, преобразуя его в структурированное изображение или последовательность кадров. Трансформерная часть обрабатывает пространственно-временные патчи видео, учась предсказывать следующий "чистый" патч на основе зашумлённого входа и текстового условия.
Ключевой момент: модель обучается на статистических закономерностях огромного массива видео (текст-видео пар). Она учится, как выглядят объекты в движении, но не учится моделировать причины этого движения. Физика для неё — это просто ещё один визуальный паттерн среди тысяч. Нет внутреннего представления о массе, инерции, силе, гравитации или коллизиях.
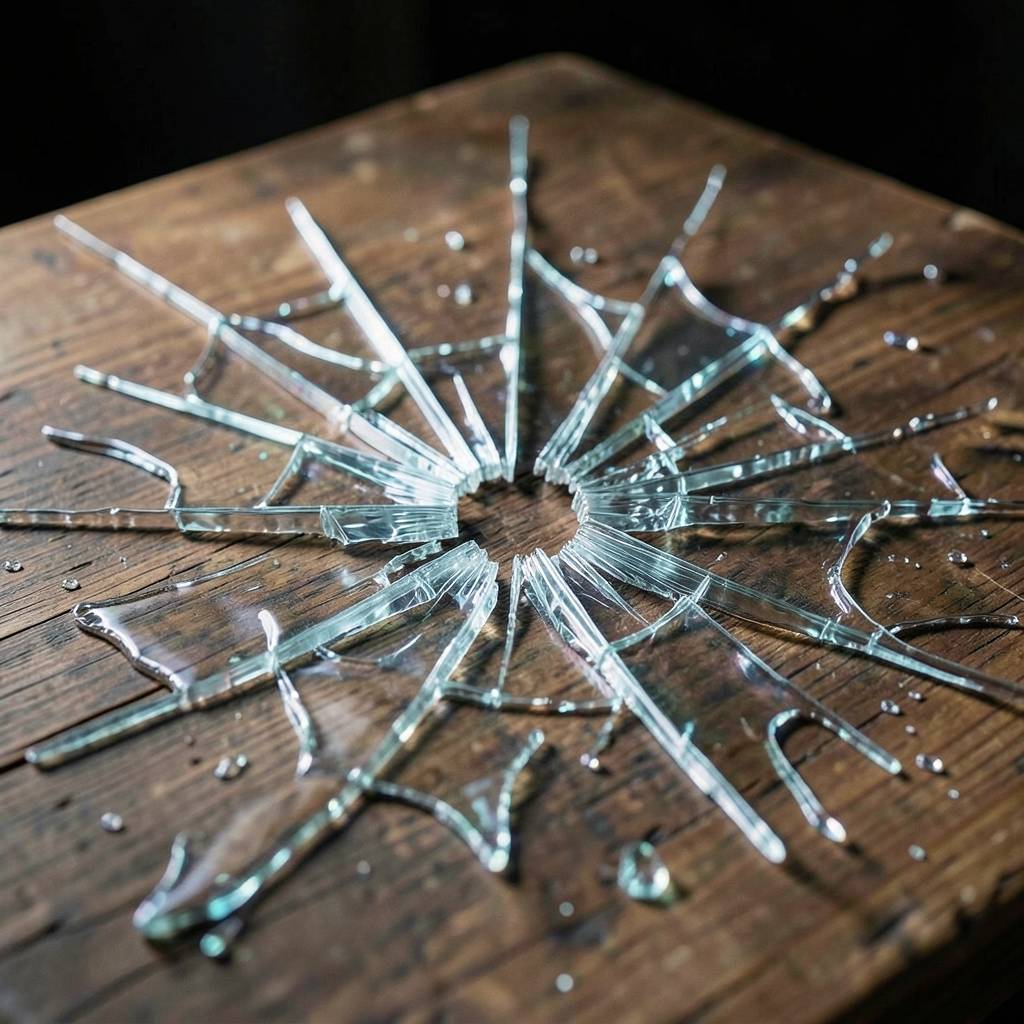
"Проблема не в качестве пикселей, а в семантике движения. ИИ видит, что стакан падает, и генерирует разбивающиеся о пол осколки, но не понимает, что осколки должны разлетаться под определённым углом в зависимости от энергии удара и материала."
Классический провал: стакан, проходящий сквозь стол
Наиболее показательный пример казуса с причинностью — генерация сцены, где стакан ставится на стол, но в следующем кадре он уже находится под столом, не разбив его и не оставив следов. Почему так происходит?
- Разрозненность пространственно-временных патчей: Модель обрабатывает каждый временной патч (несколько последовательных кадров) с некоторым перекрытием, но не имеет единого, связного представления о трёхмерной сцене и её эволюции во времени. Связь между "стакан над столом" и "стакан под столом" устанавливается чисто визуально, а не через моделирование столкновения.
- Отсутствие модели твёрдых тел: В физическом движке объекты имеют жёсткие оболочки (colliders). Их взаимодействие вычисляется детерминированно. У диффузионной модели нет такого понятия. "Стол" и "стакан" — это просто наборы пикселей с определёнными текстурами и формами. Если статистика обучающих данных содержит примеры, где объекты "проходят сквозь" другие (например, из-за плохого greenscreen или артефактов монтажа), модель усвоит это как допустимый паттерн.
- Смешение ассоциаций: Команда "поставь стакан на стол" активирует в текстовом энкодере (например, CLIP) представления о стакане и столе. Но связь "на" (контакт, поддержка) слабее, чем визуальная близость. В процессе денойзинга модель может "потерять" контакт, сгенерировав следующее состояние, где объекты просто близко расположены в кадре, но не взаимодействуют.
Что такое "внедрение физического движка" и почему это сложно?
Следующий логический шаг для разработчиков — гибридизация. Идея заключается в том, чтобы "встроить" в генеративный конвейер модуль, ответственный за физическую симуляцию. Этот модуль должен принимать на вход сгенерированные или предложенные начальные состояния объектов (позиция, скорость, вращение, форма) и предсказывать их последующие состояния, соблюдая законы Ньютона и столкновений.
Подход 1: Физика как пост-обработка
Сгенерированное видео пропускается через классический физический движок (например, на основе Bullet или PhysX), который корректирует траектории объектов. Проблема: Движок не знает, какие пиксели соответствуют какому объекту. Сегментация в реальном времени на уровне видео — нетривиальная задача. Коррекция может выглядеть неестественно, нарушая визуальную целостность.
Подход 2: Обучение с физикой в цикле
Модель обучается не только на видео, но и на синтетических данных, где каждый кадр сопровождается "истинными" физическими параметрами (глубина, скорость, нормали поверхности). Можно использовать differentiable physics rendering, где ошибка вычисляется не только по пикселям, но и по физически невозможным состояниям. Проблема: Синтетические данные далеки от реальности. Обучение требует огромных вычислительных ресурсов.
Перспективы и вызовы
Интеграция физики в генеративные модели — это не просто техническое улучшение, а качественный скачок от "что-то похожее на реальность" к "что-то, что могло бы произойти в реальности". Это критически важно для:
- Образования и симуляций: Генерация корректных учебных видео по физике, химии.
- Производственного дизайна: Визуализация того, как сборка деталей будет вести себя в процессе.
- VR/AR и игровой индустрии: Создание динамичных сцен с предсказуемой физикой.
Однако путь сложен. Нужно решить проблему многомасштабности: от моделирования коллизии двух кубиков до сложной гидродинамики или деформации мягких тел. Возможно, решение лежит в области нейро-символьного ИИ, где нейросеть генерирует высокоуровневое описание сцены (объекты, связи, намерения), а специализированный символьный движок выполняет низкоуровневую симуляцию. Но тогда встаёт вопрос о генеративности: сможет ли такая система создавать новые, невиданные ранее взаимодействия?
Опубликовано: 15 октября 2023 | 1.2K просмотров