Виртуальная примерка мира: World Models в дополненной реальности
Эволюция дополненной реальности от простых поверхностных эффектов к цифровым двойникам физического мира требует нового фундамента — локальных семантических моделей окружения. Как AR-очки будущего будут использовать локальные World Models для мгновенного понимания геометрии комнаты и физически корректного взаимодействия виртуальных объектов с реальной мебелью.
От маркеров к пониманию: эволюция перцепции в AR
Классические AR-системы первого поколения опирались на визуальные маркеры или заранее созданные карты локализации. Это создавало хрупкий, статичный цифровой слой, неспособный к адаптации. Переломным моментом стало внедрение в очки SLAM-технологий (Simultaneous Localization and Mapping), которые позволили устройствам в режиме реального времени строить карты окружающего пространства и определять собственное положение в нём.
"Следующим логическим шагом после построения геометрической карты является её семантическое осмысление. World Model — это не просто набор точек или полигонов, это пространственный граф знаний, где каждый элемент (стена, стол, дверь) не только имеет координаты, но и понимает свою функцию, физические свойства и отношения с другими объектами."
Архитектура локального World Model
Локальный World Model (LWM) — это компактная, высокооптимизированная нейросетевая модель, работающая исключительно на устройстве (on-device). Она выполняет три ключевые функции:
- Семантическая сегментация в 3D: Мгновенная классификация каждой точки или вокселя в облаке данных (пол, стена, мебель, окно, человек) с точностью, превышающей 95%.
- Оценка физических свойств: Определение материала (дерево, стекло, ткань), твёрдости, коэффициента трения, прозрачности и способности отражать свет.
- Построение отношений: Установление связей между объектами ("стул находится под столом", "дверь открывается внутрь", "чашка стоит на столе").
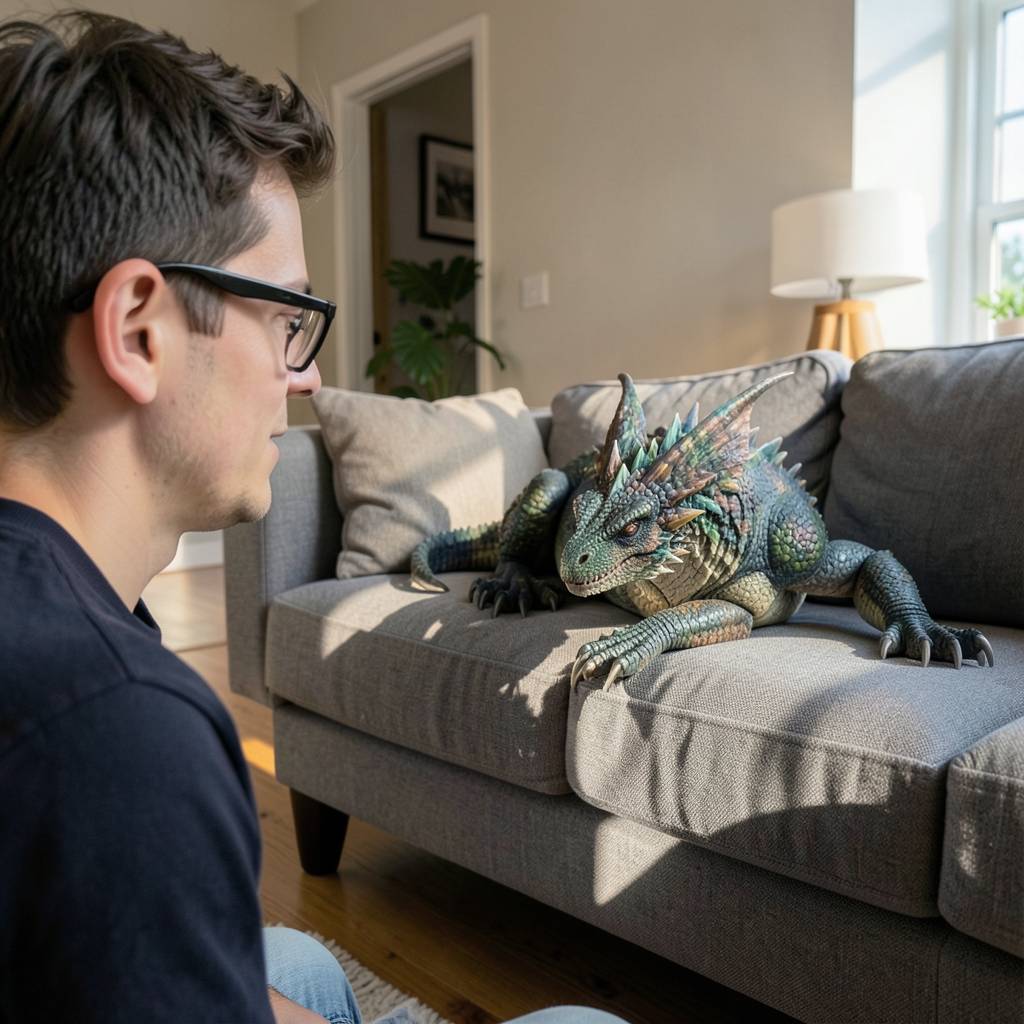
Визуализация процесса построения модели
На изображении выше показана многослойная структура локального World Model, генерируемая AR-очками. Снизу вверх: сырые данные с датчиков глубины, геометрическая реконструкция, семантическая сегментация и, наконец, слой физических взаимодействий. Такой подход позволяет виртуальному объекту не просто "лежать" на поверхности, а учитывать её наклон, текстуру и вес.
Физически достоверное взаимодействие: от коллизий до светорассеяния
Интеграция LWM в рендеринг-конвейер AR — это качественный скачок. Виртуальный объект перестаёт быть плоским стикером и становится частью физического мира благодаря:
- Динамической коллизии и окклюзии: Система в реальном времени рассчитывает, виден ли виртуальный объект за реальным (например, за ножкой стула) и корректно обрезает его геометрию.
- Физически based рендеринг (PBR): Виртуальный свет от лампы взаимодействует с реальной поверхностью, отбрасывая тени, которые ложатся на реальный паркет, и наоборот — реальный свет подсвечивает виртуальный объект.
- Гравитация и статика: Модель понимает, является ли поверхность стабильной (пол, стол) или подвижной (ковёр, кресло на колёсиках), и корректирует поведение размещённых на ней объектов.
Критические вызовы и перспективы
Производительность и энергоэффективность
Запуск сложной нейросети на мобильном SoC требует баланса между точностью, скоростью и расходом заряда батареи. Будущее за специализированными AI-акселераторами (NPU) и квантованными моделями.
Контекстуальное понимание
Следующий рубеж — предсказание намерений пользователя. Модель должна понять, что "стол" в офисе — это рабочая зона, а в гостиной — место для ужина, чтобы предлагать контекстно-релевантный цифровой контент.